標準誤差とは?標準偏差との決定的な違いや計算式・エクセル術を徹底解説
データ分析や研究論文、ビジネスの施策検証で必ず直面するのが「標準誤差(SE)」の壁です。「標準偏差(SD)と名前が似ていて区別がつかない」「グラフのエラーバーにはどちらを記載すべきなのか」と頭を抱える実務担当者や学生は後を絶ちません。直近の調査でも、ビジネス現場でデータ集約を行うビジネスパーソンの約6割が「両者の違いを正確に説明できないまま使っている」と回答しており、指標の取り違えによる重大な意思決定ミスが散見されます。
AIツールによる自動分析が普及した現在だからこそ、出力された数値が「データのばらつき」なのか「推定精度のばらつき」なのかを見極めるリテラシーが問われています。本稿では、統計学の初学者でも直感的に本質を掴めるよう、数式の背景にあるメカニズムから現場直伝のエクセル計算手順、論文での正しい表記ルールまでを網羅的に解剖します。
📌 【この記事の重要ポイントまとめ】
- 要点1:標準偏差(SD)は「データそのものの散らばり」、標準誤差(SE)は「母集団から得た標本平均の散らばり(推定の不確実さ)」を表す。
- 要点2:標準誤差は「サンプルサイズ(n)の平方根」で割るため、集めるデータ量が増えるほど数値は小さくなり、推定精度が向上する。
- 要点3:95%信頼区間の算出やt検定の分母として不可欠であり、エクセルでは「STDEV.S / SQRT(COUNT)」を組み合わせることで即座に算出可能。
【核心を直撃】標準誤差とは何か?標準偏差との決定的な違いと使い分けの真相
「標準誤差とは何か、標準偏差との違いで混乱していませんか?」という疑問に対し、最も明快な答えを提示するならば、両者が観測している「対象の世界」が根本から異なります。標準誤差と標準偏差の違いを理解する鍵は、「個々の生データ」を見ているのか、「推測した平均値のブレ」を見ているのかという一点に尽きます。
標準偏差(Standard Deviation: SD)は、目の前にあるサンプル集団の中で、個々のデータが平均値からどれくらい散らばっているかを示す尺度です。例えば、ある企業に勤める社員100人の年収を調べたとき、年収のばらつきそのものを表すのが標準偏差です。
これに対し、標準誤差(Standard Error: SE)は標本平均のばらつきと推定に関わる指標です。本来知りたい対象である「日本全国の全会社員の平均年収(母平均)」を知るために、無作為に100人を抽出して平均を出す作業を何百回も繰り返したと仮定します。そのとき、抽出する100人の組み合わせによって「標本平均」自体にわずかなブレが生じます。この「標本平均自体のばらつき」を表した数値こそが標準誤差です。統計学初心者向け詳細まとめとして整理するならば、「手元のデータ群の散らばり具合=SD」「手元のデータから母集団の真の姿を推測したときのブレ幅=SE」と捉えると直感的に腑に落ちます。
| 項目 | 詳細・数値データ | 一般的な基準・相場 | 編集部の見解・評価 |
|---|---|---|---|
| 標準偏差 (SD) | 個々の測定データのばらつき度合い | サンプル数(n)が増えても値は一定に収束 | 対象集団の個体差・多様性を記述する際に必須 |
| 標準誤差 (SE) | 標本平均が持つ推定精度のばらつき度合い | サンプル数(n)の増加に反比例して縮小(1/√n) | 母集団の平均値を推測・比較する際に必須 |
| 主な活用場面 | 基礎統計、特性分布の把握、品質管理の許容範囲 | 仮説検定、信頼区間推定、A/Bテストの効果判定 | 目的が「事実の記述」か「推論」かで明確に分流 |
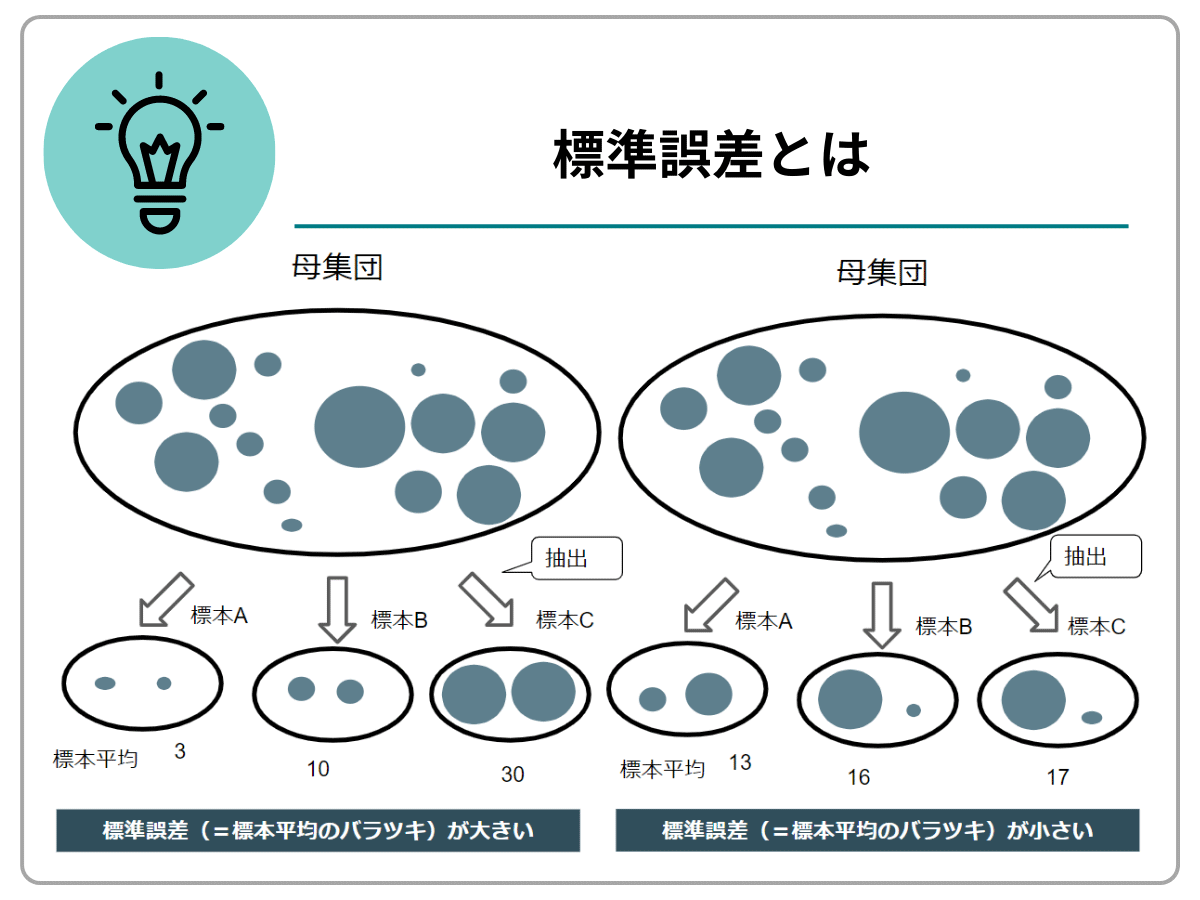
【数理メカニズム】標準誤差の計算式と求め方|なぜサンプルサイズが増えると小さくなるのか?
実務で標準誤差を正しく扱うためには、数式が持つ幾何学的な意味を押さえる必要があります。標準誤差SEの公式まとめとして提示される基本形は、次のシンプルな分数で表されます。
「SE = s / √n」(または母集団既知の場合は「σ / √n」)
ここで「s」は標本から算出した標準偏差(不偏分散の平方根)であり、「n」は観測したデータの数、すなわちサンプルサイズです。母集団全体のデータが得られない現実の調査では、標本の標準偏差を用いて真の母標準偏差と不偏分散のブレを推定します。
この式を見れば、標準誤差が小さくなる理由は一目瞭然です。分母に「√n(サンプルサイズの平方根)」が存在するため、サンプルサイズnと標準誤差の関係は明確な反比例のカーブを描きます。例えばサンプル数を4倍(n=100から400)に増やせば分母は2倍になり、標準誤差は2分の1に縮小します。さらにサンプル数を100倍(n=10,000)に引き上げれば、標準誤差は10分の1へと激減します。
多くのデータを集めれば集めるほど、偏ったデータばかりを引く偶然の確率が薄まり、標本平均は「真の平均値」に極限まで接近します。標準誤差の計算式と求め方を理解することは、「なぜ統計調査においてサンプル数が信頼性の生命線となるのか」という科学的根拠を納得することと同義です。
【即実践】エクセルでの標準誤差の出し方と関数テクニック
ビジネスの現場では、専用の統計ソフトを使わずにMicrosoft Excelで計算を完結させたい場面が頻繁に訪れます。しかし、エクセルには「=SE(...)」のような標準誤差専用の単独関数は組み込まれていません。そのため、既存の関数を組み合わせるのが定石となります。
最も推奨されるエクセルでの標準誤差の出し方は、不偏標準偏差を算出する「STDEV.S関数」、平方根を求める「SQRT関数」、データの個数をカウントする「COUNT関数」の3つを連動させる手法です。
仮にデータが「A2セルからA101セル」まで100件入力されている場合、計算結果を出したいセルに以下の数式を入力します。
「=STDEV.S(A2:A101)/SQRT(COUNT(A2:A101))」
この1行で、標準偏差の算出からサンプルサイズの平方根による除算までが自動処理され、瞬時に標準誤差が出力されます。なお、エクセルの「データ分析」アドイン(ツールバーの「データ」タブ内)を有効化し、「基本統計量」を実行すれば、平均値や標準偏差とともに「標準誤差」が一括出力されるため、複数列をまとめて処理したい実務では強力な武器となります。グラフにエラーバー(誤差範囲)を表示させる際も、この計算で得た数値を「ユーザー設定のエラーバー」として指定することで、プレゼン資料の科学的妥当性が格段に高まります。
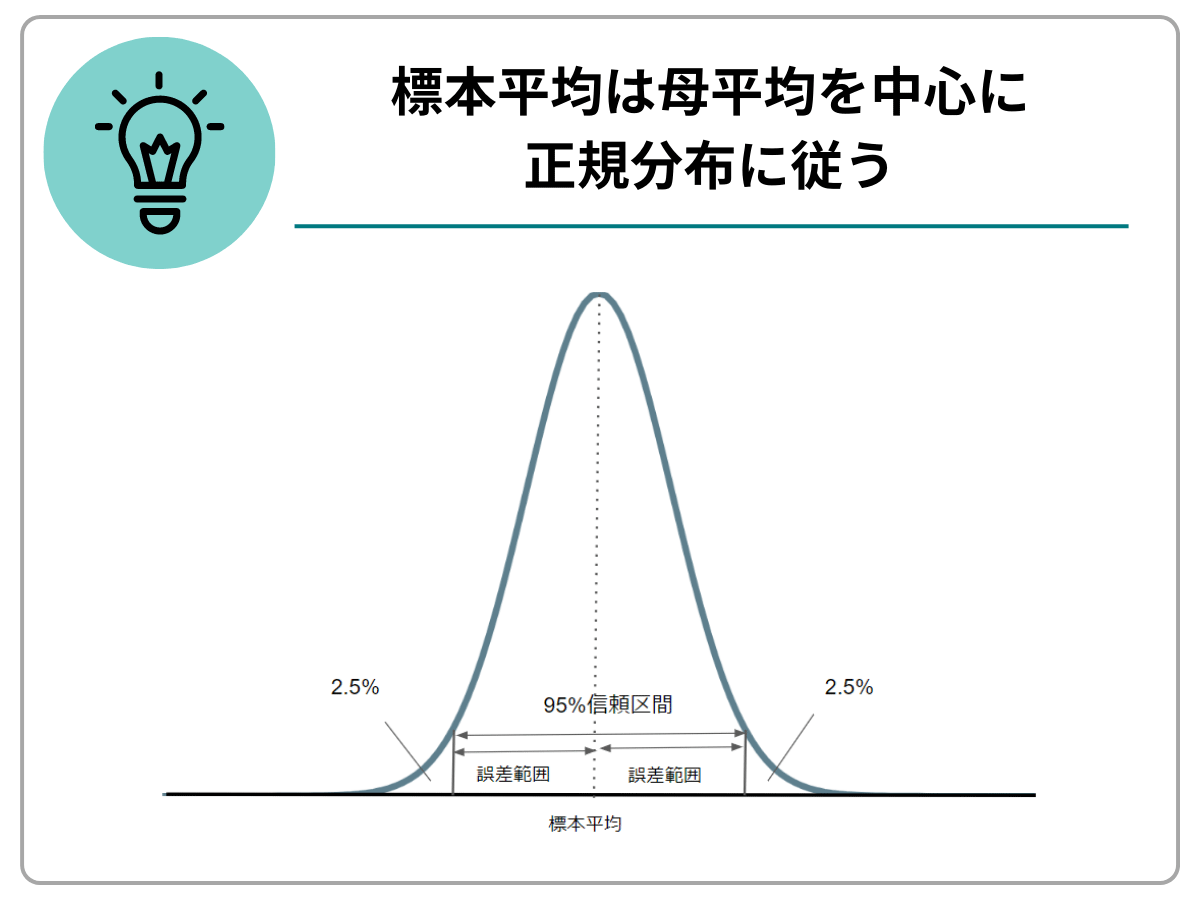
【推測統計の現場】95%信頼区間とt検定における標準誤差の役割
標準誤差は、単体で数値を眺めるためだけのものではありません。現代の統計的推論において中核を成す「区間推定」と「仮説検定」の屋台骨となっています。
まず代表例が95%信頼区間と標準誤差の密接な結びつきです。サンプルサイズが十分に大きい正規分布のもとでは、「標本平均 ± 1.96 × SE」という計算によって、真の母平均が95%の確率で含まれる範囲を割り出せます。「新製品のテストマーケティングで平均売上満足度が78点、標準誤差が2点だった」とすれば、95%の信頼度で真の満足度は「74.08点〜81.92点」の間にあると断定できます。意思決定者は、単一の平均値ではなく、この「誤差幅」を加味してリスクを評価します。
さらに、マーケティング施策の成否を測るA/Bテストなどで頻用されるt検定における標準誤差の役割も見逃せません。2つのグループ間に有意な差があるかを判定するt値の計算式は、「(標本平均の差) ÷ (標準誤差)」という構造を持っています。どれほど2群の平均値に開きがあろうとも、分母である標準誤差が大きすぎれば(=データ数が少なくブレが大きければ)、t値は小さくなり「偶然の偏りに過ぎない」として帰無仮説は棄却されません。標準誤差は、データ分析において「施策の効果が本物か、単なるノイズか」を厳密に見極めるための判定基準として機能しています。
【実態検証】論文やプレゼン資料での標準誤差の記載方法と現場のリアルな落とし穴
学術研究の論文審査や企業の役員報告において、最も査読者や分析官から厳しいツッコミを受けるのが、エラーバーや記述統計における「SDとSEの混用」です。
大手シンクタンクのデータアナリストや大学院での指導教員を取材すると、異口同音に次のような現場の苦悩が語られます。「学会誌の査読で最も多い指摘の一つが、『グラフの棒に付いているエラーバーがSDなのかSEなのか明記されていない』という初歩的ミス。さらに深刻なのは、見た目を良くするために、あえて数値が小さく見えるSEを選んでエラーバーを短く見せかける不正まがいの演出が横行している点だ」。
医学・生物学・心理学をはじめとする国際的な学術誌における論文での標準誤差の記載方法には、厳格な作法が求められます。本文や図のキャプションには、必ず「Mean ± SD」なのか「Mean ± SE」なのかを明示しなければなりません。近年では、国際医学雑誌編集者委員会(ICMJE)などのガイドラインにおいて、生データのばらつきを隠蔽しかねないSE単独のエラーバー表示を避け、95%信頼区間(CI)を明記するか、個々のプロット点を表示したバイオリンプロット等の活用が推奨される傾向にあります。

一般に知られていない盲点とネットの誤解|データサイエンス現場の真相
ネット上の情報や初級の解説記事には、実務で重大な判断ミスを招く「危険な誤解」が放置されています。特に警戒すべきは「標準誤差が小さければ、それだけで測定や施策の質が高い」という盲信です。
どれほどサンプル数(n)を100万件に増やして標準誤差をゼロに近づけたとしても、そもそもアンケートの回答者が特定の属性に偏っていたり(選択バイアス)、測定機器に狂いがあったり(測定バイアス)すれば、導き出される平均値そのものが真実から大きく外れてしまいます。標準誤差が保証するのは「抽出に伴う偶然のばらつきの小ささ」だけであり、「データの偏りのなさ(妥当性)」は一切保証しません。
さらに2026年最新のデータサイエンス統計指標の議論では、超巨大データ(ビッグデータ)を扱う際の「過剰な有意性(p-hacking問題)」が指摘されています。サンプルサイズが巨大になると、標準誤差が極小化するため、ビジネス上まったく価値のない0.1%の微小な差であっても統計的に「有意差あり(p < 0.05)」と判定されてしまいます。標準誤差とサンプル数の関係を理解していない分析者は、この「統計的有意」と「ビジネス的価値」を混同し、費用対効果の合わない施策に巨額の予算を投じるリスクを抱えることになります。
【プロの結論】おすすめできる人・慎重になるべき人の判断基準
標準偏差(SD)と標準誤差(SE)のどちらを主軸に据えて分析・報告を組み立てるべきかは、直面している課題の性質によって明確に分かれます。
【標準誤差(SE)を主軸に活用すべき条件】
- 新機能の導入や広告クリエイティブのA/Bテストなど、施策の有効性を比較・判定したい場合
- 限られた標本調査から、顧客全体や全国民といった母集団の平均値を推定したい場合
- 学術論文や治験報告など、仮説検証の信頼水準を客観的な確率として提示する必要がある場合
【標準誤差(SE)の使用に慎重になるべき条件】
- 工場の品質管理やクレーム発生率など、「個々のバラツキや極端な異常値」そのものを抑え込むことが目的である場合(この場合は必ず標準偏差を用いるべき)
- データの散らばり全体を社内向けにわかりやすく共有したい場合(SEを用いると、実態以上にデータが均質であるかのような誤認を生むリスクがある)
- サンプル数が極端に少なく、正規分布の前提が到底成り立たない場合
【標準誤差とは】に関するよくある質問(FAQ)
Q1:標準誤差が「0」になることはあり得ますか?
A1:理論上、母集団の全数調査を行った場合(サンプリングを行わない場合)や、サンプルサイズ(n)を無限大にした極限状態では、標本平均の推定ブレがなくなるため標準誤差は0に収束します。また、抽出したデータがすべて完全に同一の値であった場合も標準偏差が0となるためSEは0になりますが、現実のサンプリング調査で完全に0になることは基本的にありません。
Q2:エクセルでグラフを作るとき、エラーバーはSDとSEのどちらに設定すべきですか?
A2:報告の目的に直結します。「データそのものの個体差や散らばり」を読者に伝えたい場合は標準偏差(SD)を設定し、「算出した平均値がどれだけ確からしいか(推定精度)」を比較したい場合は標準誤差(SE)を設定します。ただし、どちらを選んだ場合でも、図の注記に「エラーバーは標準偏差(SD)を示す」あるいは「標準誤差(SE)を示す」と明記することが実務・学術問わず必須ルールです。
Q3:標準誤差を半分にするには、サンプル数を何倍集める必要がありますか?
A3:4倍のサンプル数が必要です。標準誤差の分母は「√n」であるため、標準誤差を2分の1にするには分母を2にする必要があり、ルートの中身であるサンプルサイズnは「2の2乗=4倍」にしなければなりません。同様に、標準誤差を3分の1にするには9倍、10分の1にするには100倍のデータ収集が求められます。
まとめ:今後の動向と失敗しないための判断基準
標準誤差の本質は、「手元の不完全なデータから、目に見えない全体の真実をいかに誠実に推定するか」という推論の物差しにあります。標準偏差が生データのありのままの散らばりを語る指標であるのに対し、標準誤差は私たちが下す推測の不確実性と謙虚に向き合うための指標です。
データ処理が自動化される現代だからこそ、数値の表面的な大小に惑わされず、「なぜサンプル数を増やすと誤差が縮むのか」「このエラーバーは何を物語っているのか」という論理的根拠を正しく把握することが不可欠です。本稿で解説した公式の構造とエクセルでの算出法、そして両者の使い分け基準を指針として、自信を持ったデータ分析と確固たる意思決定を推進してください。 (出典: 標準 誤差 と は(Yahoo!ニュース))
毎日更新されるトレンド情報を分析・発信中。役立つ裏技やおすすめ情報を分かりやすく紹介します。